ステップ 1
何でも入力
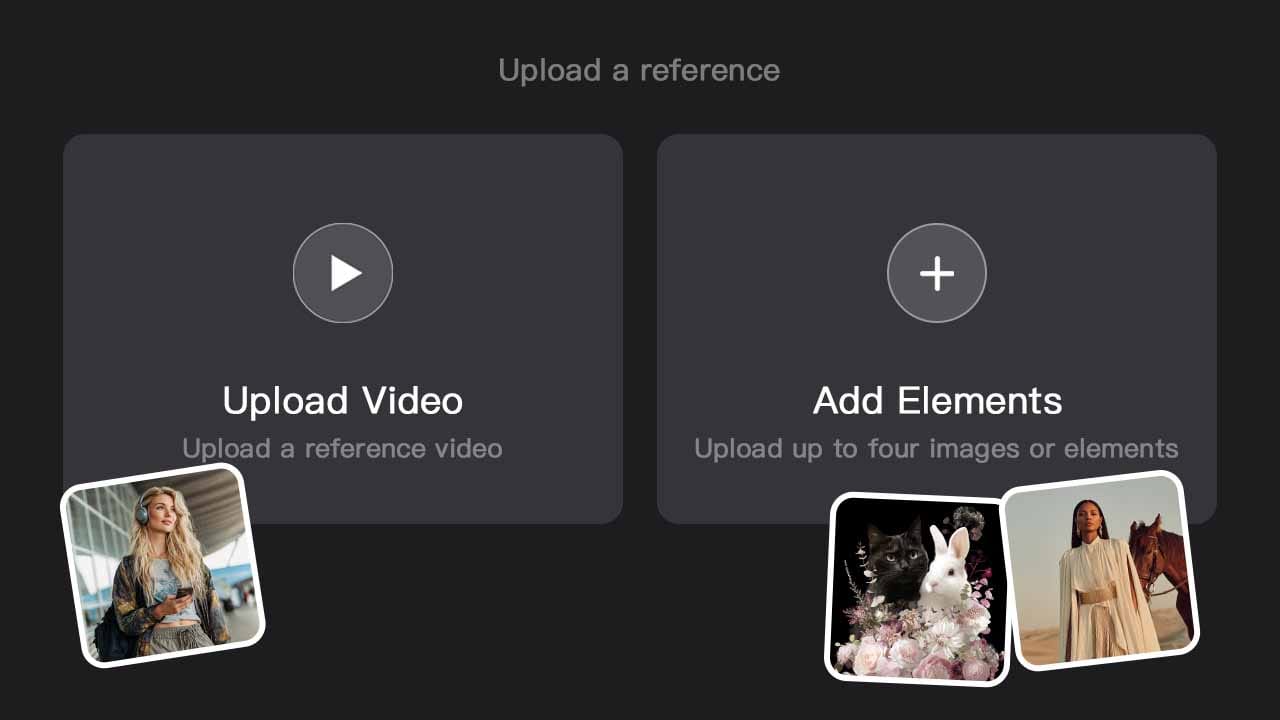
参照画像(最大7枚)、動画クリップをアップロード、またはテキストアイデアから始める。
参照画像(最大7枚)、動画クリップをアップロード、またはテキストアイデアから始める。
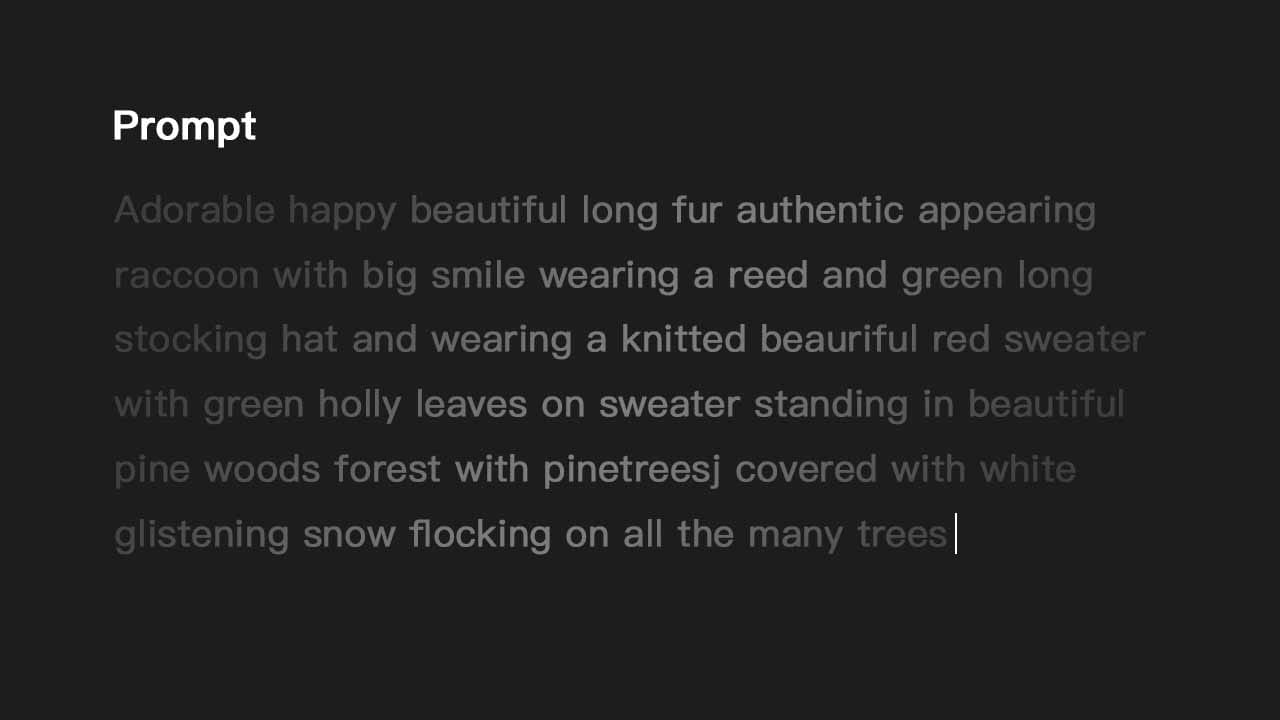
自然言語でシーンを指示し、希望するシナリオを記述
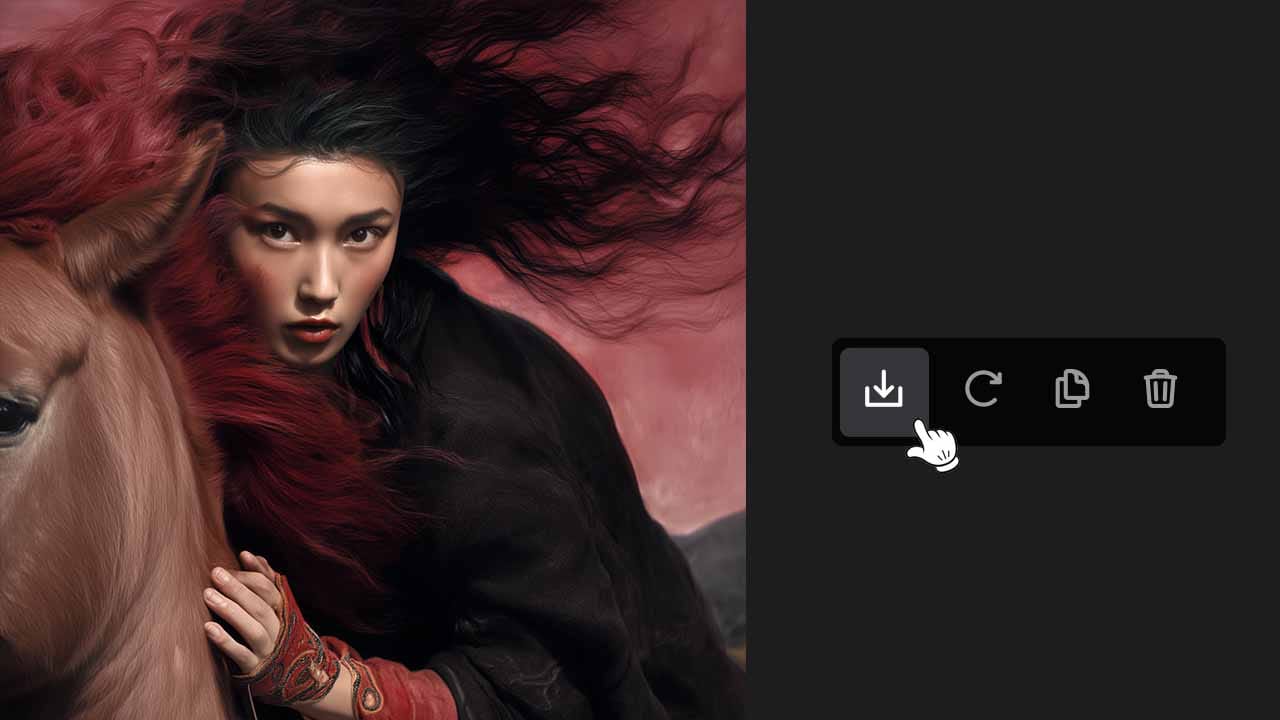
数秒で高忠実度の動画を取得し、ショットを完璧にするためにシームレスに編集
シンプルな生成を超えて。ピクセルレベルの精度で編集し、現実を再形成。
1枚の画像をアップロード → シネマティッククリップを取得
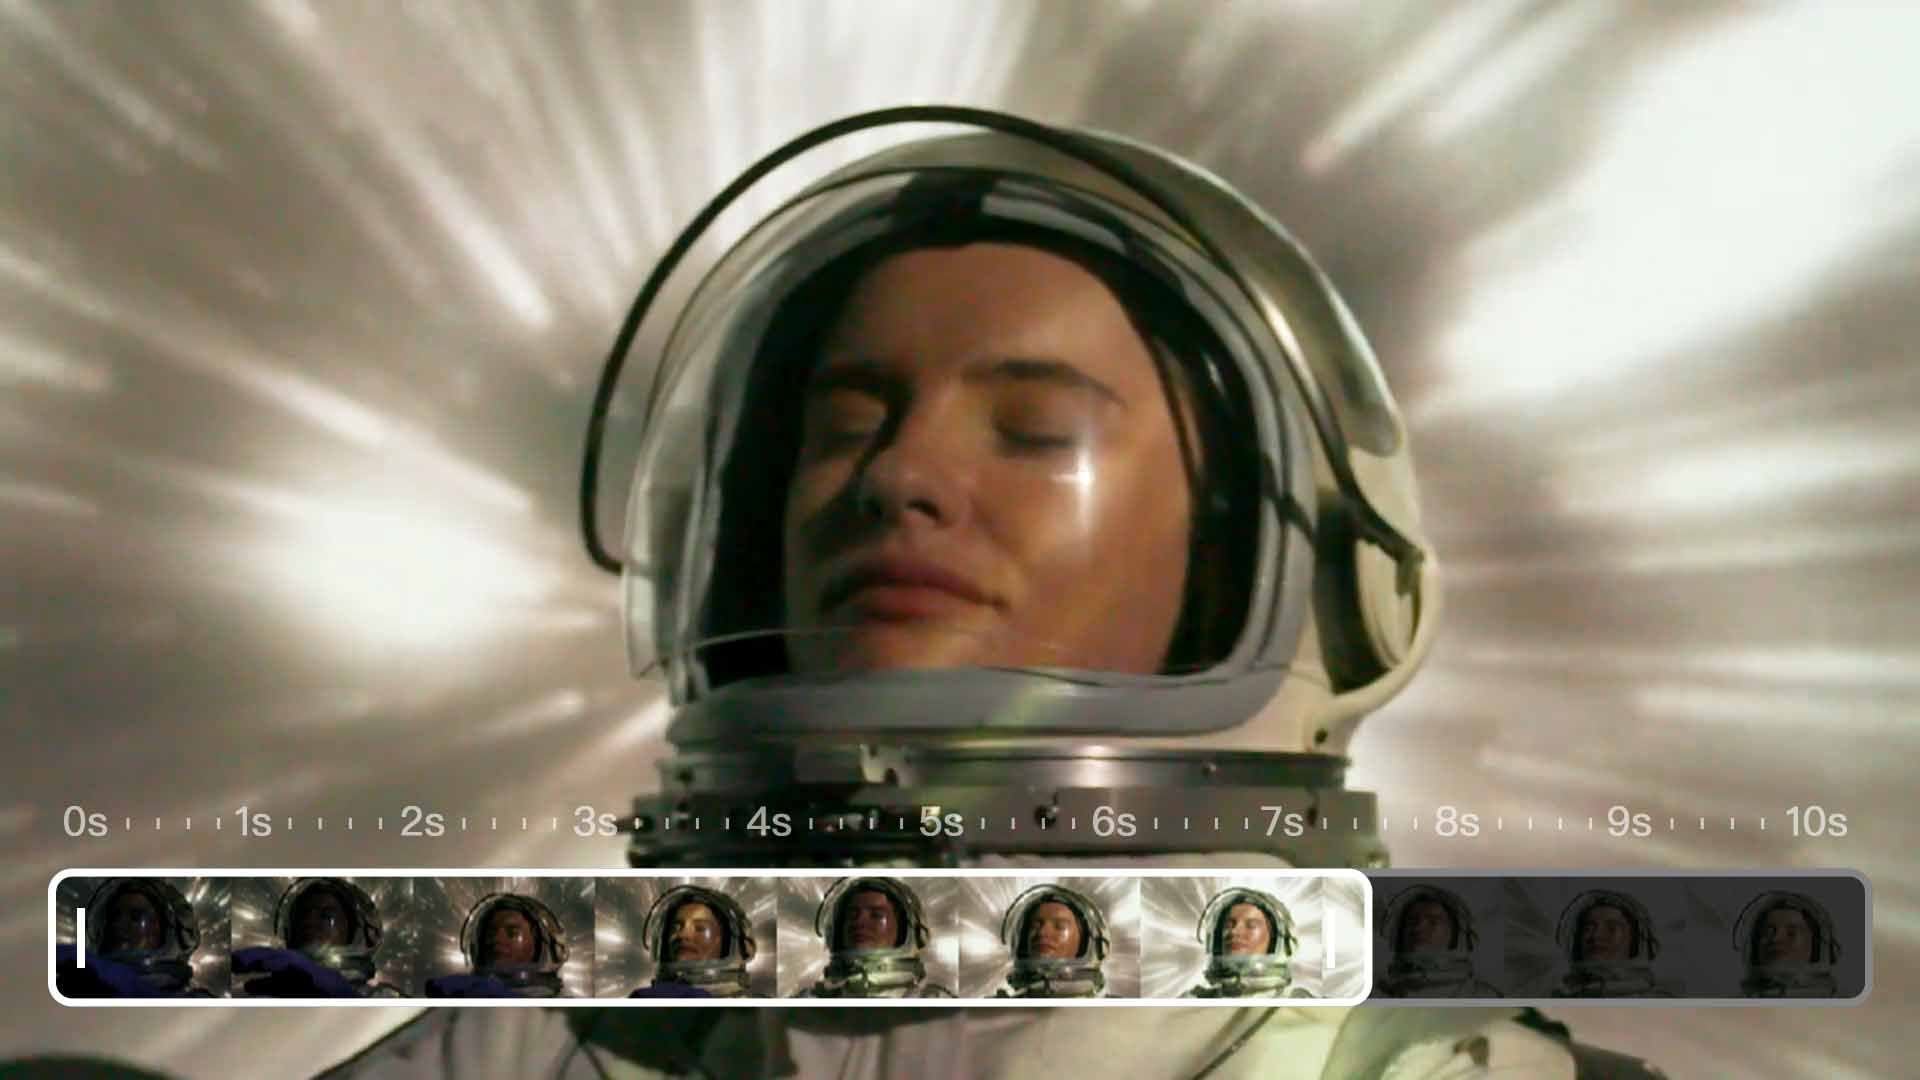
ストーリーテリング、広告クリップ、プレビュー、UGCイントロに最適な長さ
開始フレーム+終了フレームをアップロード。モデルが動きを自然に処理し、極めて安定したアイデンティティとシームレスなトランジションを提供
キャラクターアイデンティティ、衣装、小道具、環境アングルに複数の写真を使用。Kling O1はそれらすべてをシームレスにマージ
動画生成と編集の壁を打ち破る。1つのプロンプトでゼロから作成、またはテキスト、画像、動画でシームレスに映像を編集
マスキングやロトスコープを忘れて。自然言語で背景の人物を削除、天候を変更、被写体を入れ替える — ピクセルレベルの精度で
複数のショットでキャラクターと小道具の一貫性を保つ。カメラが動いたりアングルが変わっても、アイデンティティ、衣装、ディテールを完璧に保持
手間なくプロ品質を実現
画像から無料でプロ仕様の4K動画を制作。HeadSwapの先進的AIが、シャープなビジュアルと滑らかなアニメーションを毎回簡単に提供します。
シームレスなキャラクターの一貫性
動画を通じて顔を一貫してリアルに保ち、自然な表情とアイデンティティを常に揃えて、より信じられる結果を実現します。
シンプルで直感的なUI
数クリックとシンプルなプロンプトで、写真をショート動画に変換する究極の手軽さを体験。技術スキルや事前の動画編集経験は不要です。
Kling Video O1は世界初の統合マルチモーダル動画モデルです。作成と編集を分離する従来のツールとは異なり、Video O1はすべてを1つの場所で処理します。テキストや画像からシネマティック動画を生成し、シンプルな会話で編集、拡張、リスタイルできます。
ペースを完全にコントロールできます。3〜10秒の任意のクリップを生成できます。
Kling O1はAI動画における最大の課題 — 役者の見た目を同じに保つこと — を解決します。エレメントライブラリを使ってキャラクターや小道具の参照画像をアップロードできます。モデルは人間のディレクターと同じように特徴を「記憶」し、異なるショット、アングル、ライティング条件で一貫性を保ちます。
いいえ。Kling Video O1はマスキング、ロトスコープ、フレームごとの編集などの手作業を置き換えるように設計されています。
はい、複雑なソフトウェアは不要です。セマンティック編集で、コマンドを入力するだけで動画を編集したり、動画や画像の参照を使用したりできます。
はい。Kling O1 の Semantic Editing では、生成済みの動画を自然言語コマンドで修正できます。複雑なソフトウェア、マスキング、ロトスコープは不要です。「左側の通行人を削除」「天気を雨に変更」「被写体の服装を差し替え」などと入力すると、O1 がピクセルレベルの精度で変更を適用します。HeadSwap では画像や動画の参照を使って編集をガイドすることもできます。


