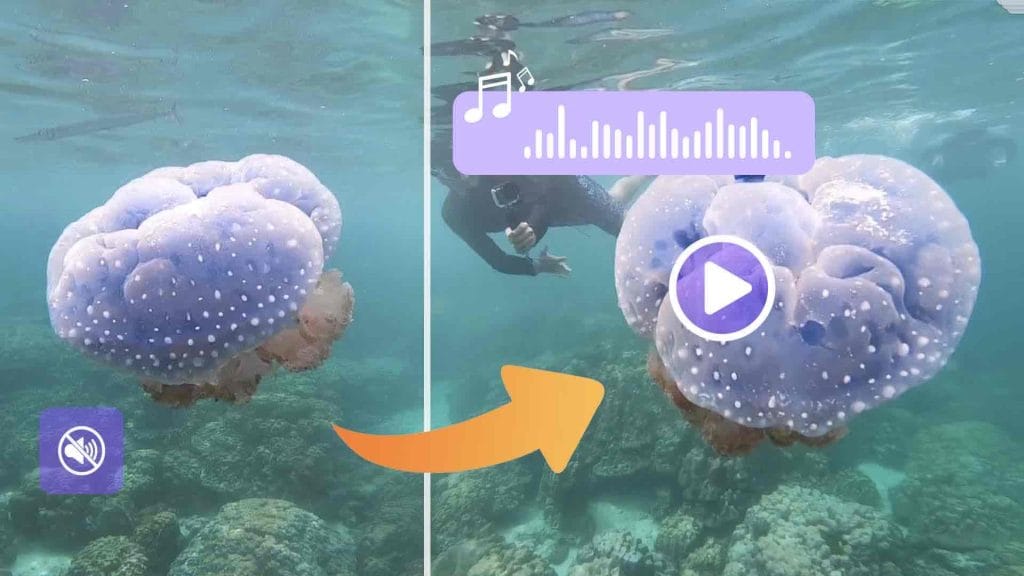
背景音乐
AI 与你的视频节奏完美契合。
AI 与你的视频节奏完美契合。
添加真实的拟音和环境音效。
智能 Chain-of-Thought 推理,结果接近真人。
可安心用于商业项目的音频。
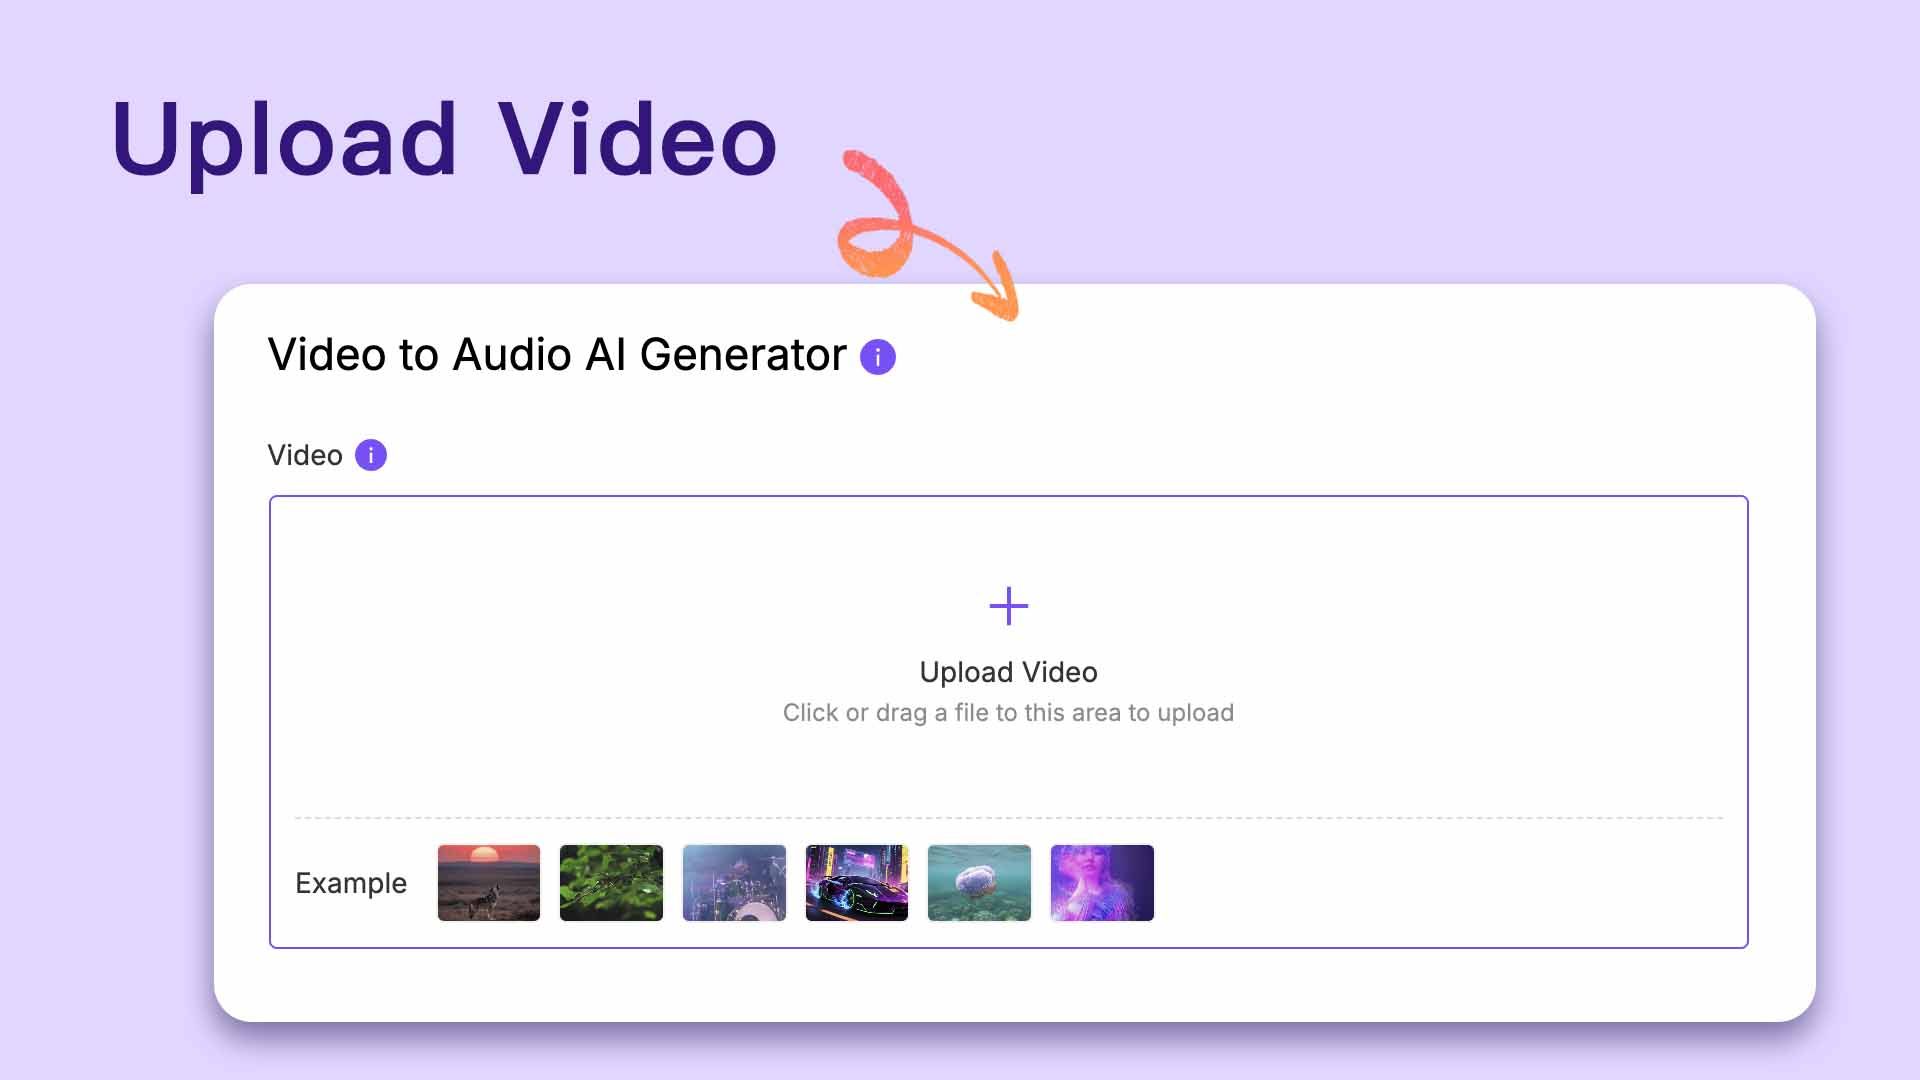
直接拖放视频,无需担心格式。
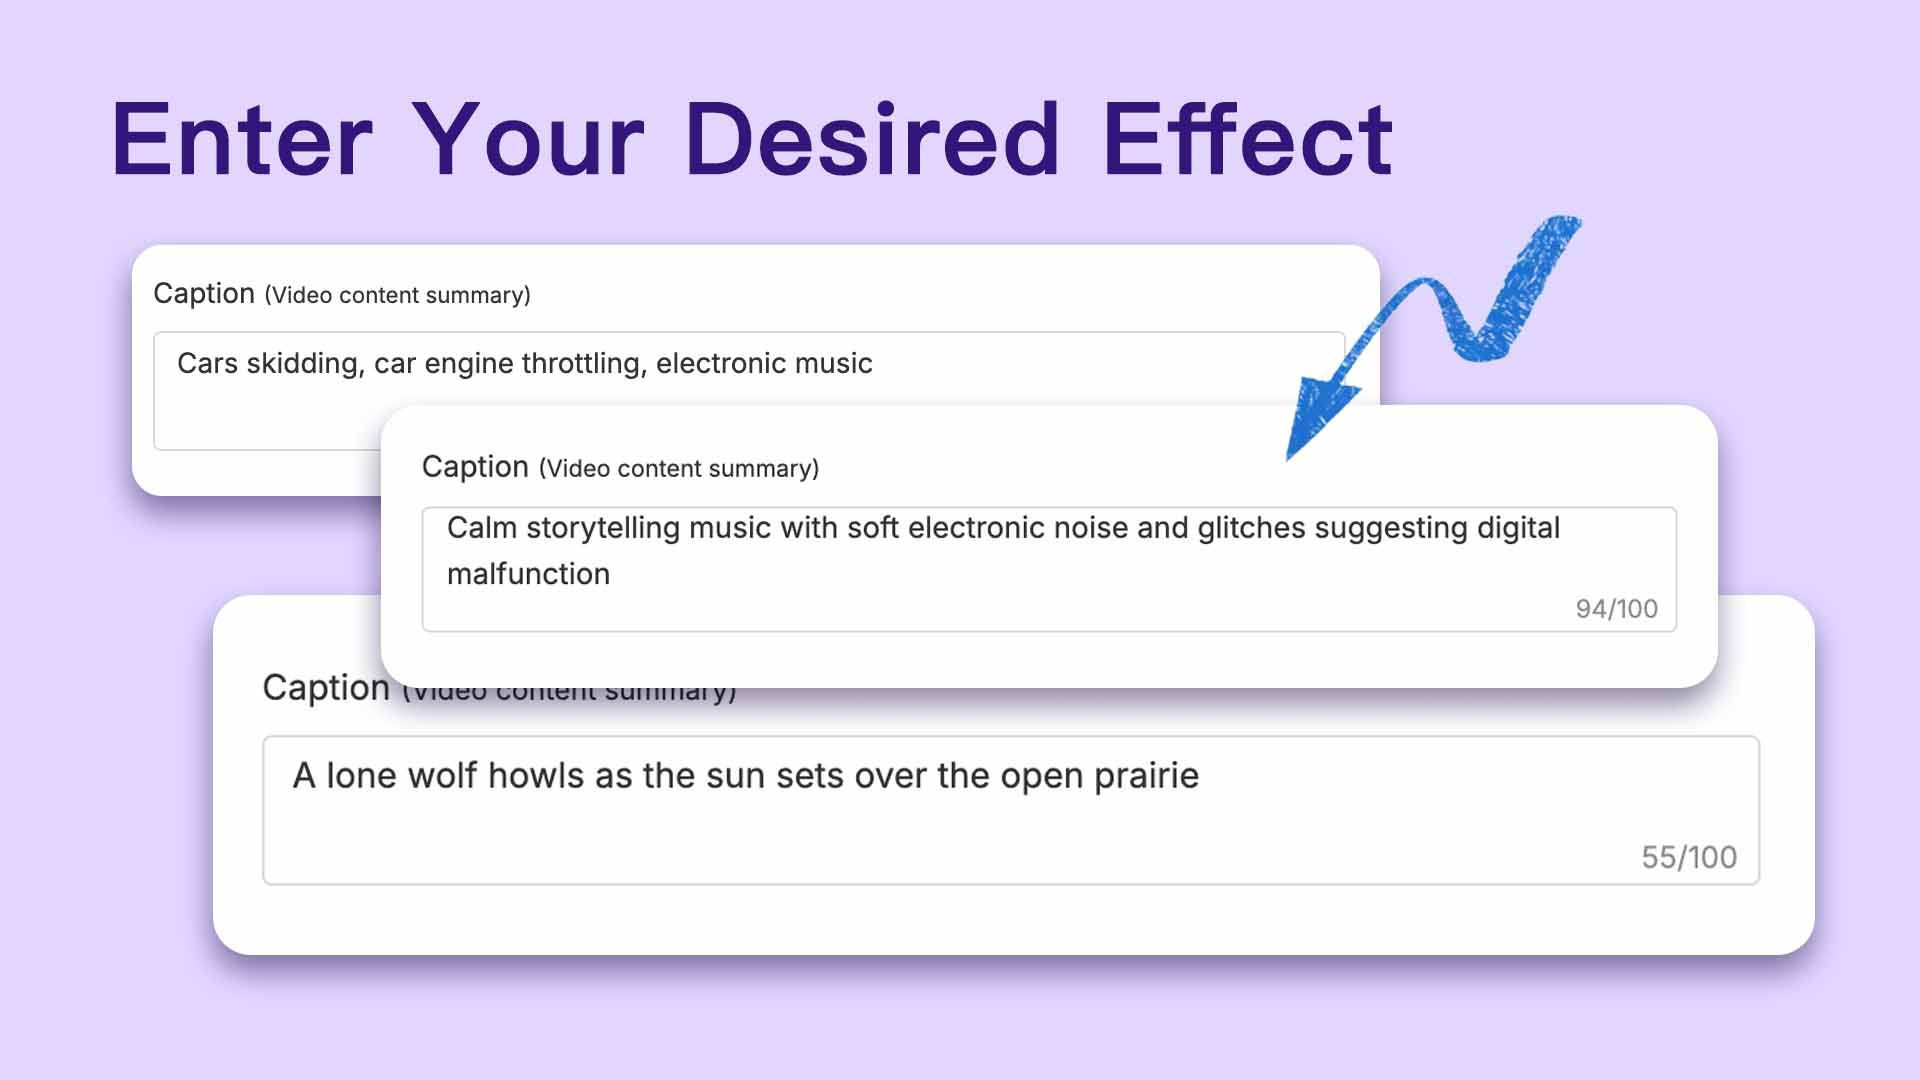
描述你想要的氛围或风格——让 AI 理解你的创意。
ThinkSound AI 即刻为视频生成音乐与音效。
聆听效果,根据需要调整,然后下载已完成的视频。
与基础工具不同,ThinkSound 采用多阶段 AI 推理,交付专业级配乐:
让我们的视频配音方案成为创作者最灵活、最强大的选择。
一次付费即可解锁全部强大 AI 功能,无需按次计费。视频生成、声音克隆、图像处理一应俱全。多创作,少花钱。
由 HeadSwap 行业领先技术驱动,工具输出自然、逼真、细节丰富。从画面到音频,每一份结果都达到专业标准。
无使用次数限制——想生成多少就生成多少,随时自由创作。大胆尝试不同风格,反复迭代你的创意,不必担心额度很快用完。你还可以将此工具与 AI Text to Image、Kling 3.0 video 和 AI Avatars 搭配,构建端到端工作流。
你可以将 HeadSwap 生成的 AI 音乐和音频用于几乎任何项目——YouTube 视频、播客、游戏、短片、预告片、AI 艺术短片、社媒内容(TikTok、Reels、Shorts)、有声书、广告、直播、在线学习视频和客户交付。使用付费计划还可获得永久非独占商业许可,因此可以将基于 HeadSwap 音频制作的内容变现,无需担心版权警告或按片段支付版税。HeadSwap 保留底层模型和音频库的所有权。
你会获得生成并下载音轨的永久非独占许可。该许可允许你将音乐用于视频或音频内容(播客、访谈节目、有声书),并安心变现。不过,HeadSwap 仍保留由 AI 音乐创建器生成并下载的音轨所有权。
HeadSwap Video to Audio 的优势在于结合了先进上下文理解、实时场景分析和 ThinkSound 多阶段推理引擎。大多数音频生成器只会附加通用背景音乐,而 HeadSwap 会分析画面中发生的事情——不同表面的脚步声、交通密度、天气、情绪——并在单次生成中创建匹配的拟音、环境声和音乐。结果是一条像为你的具体片段自然创作的声音轨,而不是简单叠加的素材循环。
HeadSwap Video to Audio 使用 ThinkSound,这是一种多阶段推理 AI,会先分析视觉内容(物体、运动、场景、情绪),再规划与画面动作对齐的分层声音轨,包括拟音、环境噪声和音乐。你可以用简单文字提示引导生成,例如“make it cinematic”、“add suspense”、“softer ambience”,也可以点击时间线中的对象来细化特定声音。最终音频会与视频帧同步渲染,输出自然且精致。
可以。HeadSwap Video to Audio 支持 MP4 和 MOV 视频,每次生成最长 30 秒。无论你处理的是社媒短片、广告创意、动画循环,还是较长场景片段,ThinkSound 都能输出稳定自然的声音。对于更长项目,可以按 30 秒分段生成音频并在编辑器中合成——只要提示词保持一致,模型就能维持跨片段的音频风格和情绪连续性。


