
创作内容
用 Minimax 或 ElevenLabs 生成高度逼真自然的声音克隆。请注意,输出质量直接取决于录音的质量。
用 Minimax 或 ElevenLabs 生成高度逼真自然的声音克隆。请注意,输出质量直接取决于录音的质量。
无论你说什么语言、带什么口音 — 我们全都支持!可以在变声工具中修改克隆声音的口音。
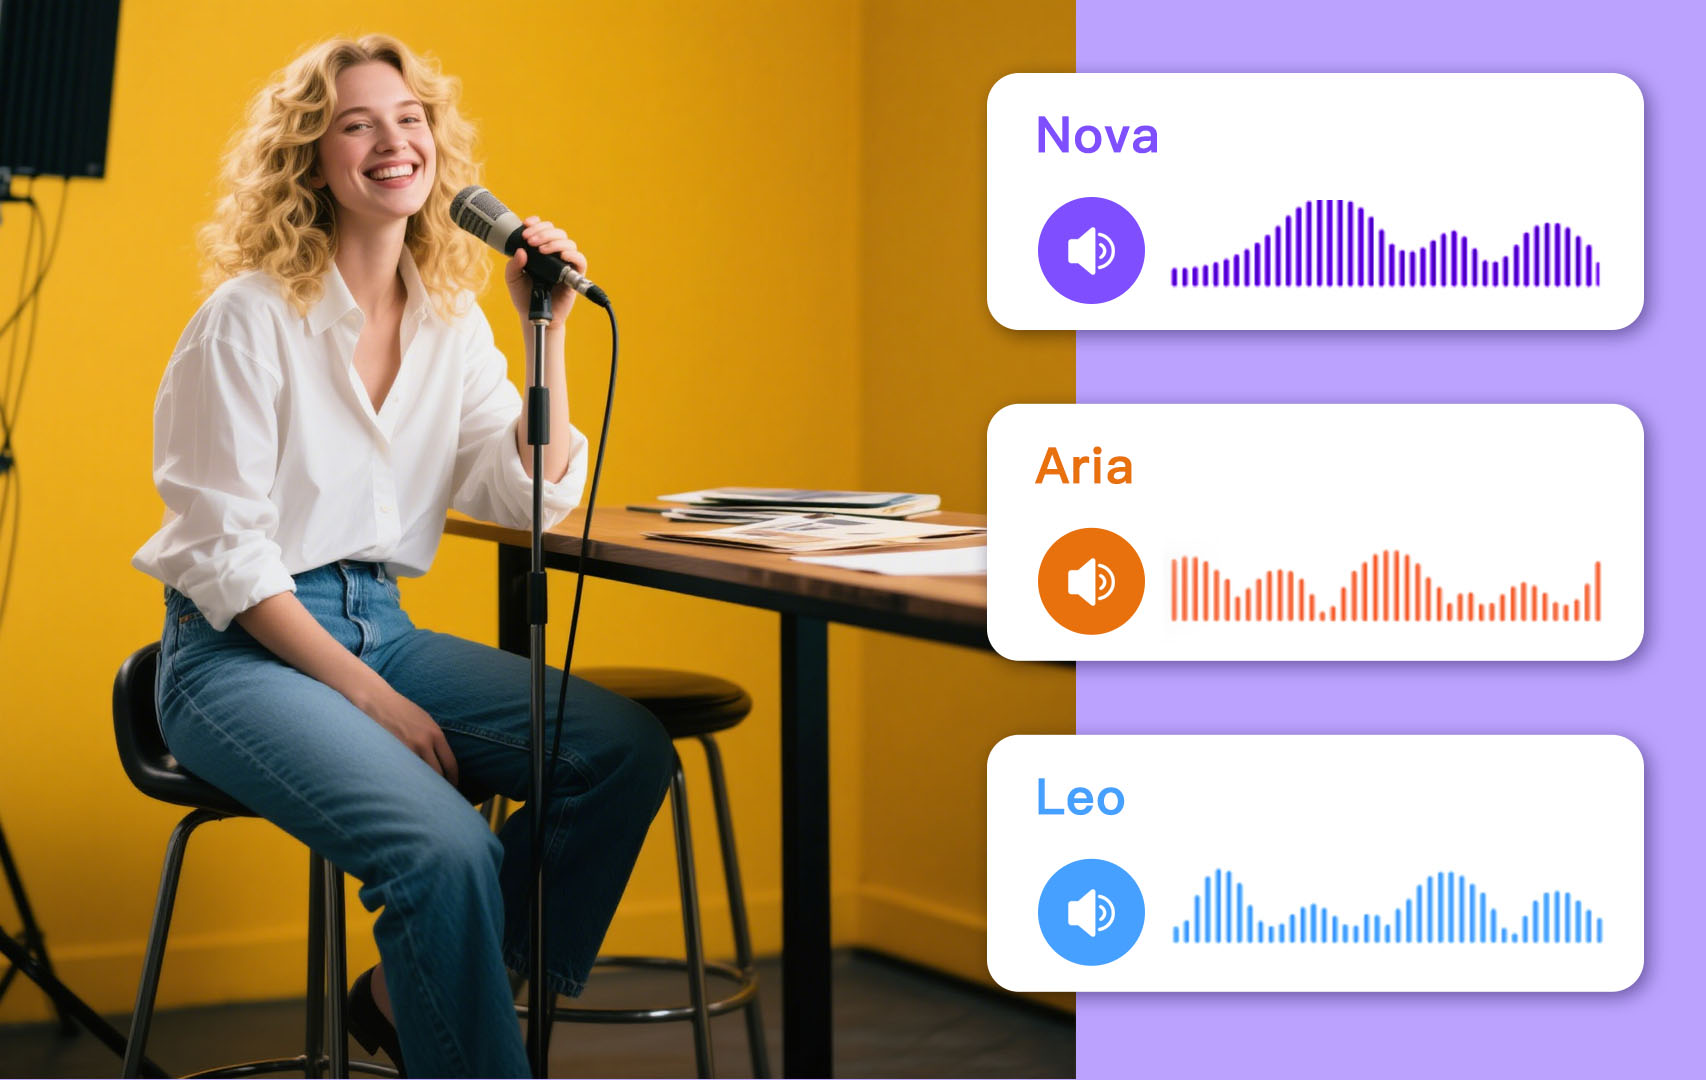
无需聘请专业歌手、也不必自己开口唱,就能创作翻唱歌曲并探索多种声乐风格。
为客户或朋友录制定制语音留言。无需反复录音,就能为沟通增添个人色彩。
提供几段清晰、高品质的音频录音。源音频越清晰,AI 声音克隆效果越好。
我们的 AI 语音引擎(搭载 ElevenLabs 或 Minimax 模型)会生成你的定制声音。几分钟内即可预览结果。
在语音或歌唱内容中使用声音克隆。集成到 HeadSwap 声音克隆工作室,编辑过程无缝顺畅。
用 Minimax 或 ElevenLabs 提供超真实、富有表现力的语音合成。AI 语音模型可复刻语气、情感和口音,输出真正接近人声的效果。
无论你说英语、普通话、西班牙语还是其他任何语言,我们的模型都支持多语言声音克隆。
几分钟即可生成高质量声音克隆。适合节奏紧张的制作流程,质量不打折扣。
用语音转语音技术把任意口语音频转换为另一个声音。通过变声工具掌控语音的情绪基调。
受益于直观的界面设计,让语音生成流程更轻松。只需上传录音、点击几下,即可获得你的声音模型。
用声音克隆技术为你的音乐制作锦上添花。尝试多种人声风格和音色,让作品契合你的艺术愿景。
一次付费即可解锁多种强大的 AI 功能 — 无需按次付费。视频创作、声音克隆、图像处理一应俱全。创作更多,花费更少。
基于 HeadSwap 业界领先的技术,我们的工具能输出自然、写实、细节丰富的结果。从画面到声音,每一项成果都达到专业水准。
无使用次数限制——想生成多少就生成多少,随时自由创作。大胆尝试不同风格,反复迭代你的创意,不必担心额度很快用完。你还可以将此工具与 AI Text to Image、Kling 3.0 video 和 AI Avatars 搭配,构建端到端工作流。
可以。使用任意 HeadSwap 付费订阅计划创建的声音克隆都包含完整商业使用权,可用于视频旁白、广告、播客、有声书、在线学习、品牌配音、IVR 系统和客户交付。你保留生成音频的完整所有权,无水印,无需署名,也无需按分钟支付版税。务必确保你拥有所上传源声音的权利(自己的声音,或已获得书面授权的声音)——HeadSwap 不支持未经同意的声音克隆。
安全,你的数据在我们这里很安全;我们非常重视你的隐私和安全。所有上传的录音都会被妥善处理,并且只会在生成声音克隆所需的时间内保留。你的声音样本不会用于进一步训练我们的声音克隆技术,也不会用于增强其他 AI 产品。
声音样本质量越高,生成的声音模型就越好。录音应只有一位说话者,声音清晰,且没有背景噪音、音乐、回声或混响等效果。请避免长时间静音、多人说话,以及空调声、街道噪音等环境声。
处理时间取决于你上传录音的长度和清晰度,但大多数声音克隆会在上传后 2 分钟内完成。HeadSwap 并行支持 MiniMax、ElevenLabs 和 Cartesia 模型,你可以并排预览多个引擎,再选择最匹配的结果。较长录音(最长 60 秒)生成时间会稍长,但得到的声音克隆能捕捉更多细节——音高、音色、口音和情绪范围——输出质量更高。
你可以上传一段 MP3、WAV、M4A、MP4 或 MOV 格式的录音来创建声音克隆。录音时长必须为 10 到 60 秒,文件最大 500MB。声音质量比录音长度更重要,建议使用清晰的高质量录音。
声音克隆是从音频样本中复刻或合成某个人声音的过程,可创建一个能朗读你提供任意文本的数字声音副本。在 HeadSwap 上,声音克隆由 MiniMax、ElevenLabs 和 Cartesia 驱动——这些都是领先的多语言 TTS 模型——支持自然英语、普通话、西班牙语、法语、德语、日语和 30 多种其他语言。它可用于视频旁白、播客、有声书、翻唱、配音、声音保存和个性化语音消息——无需每一句都重新录制。